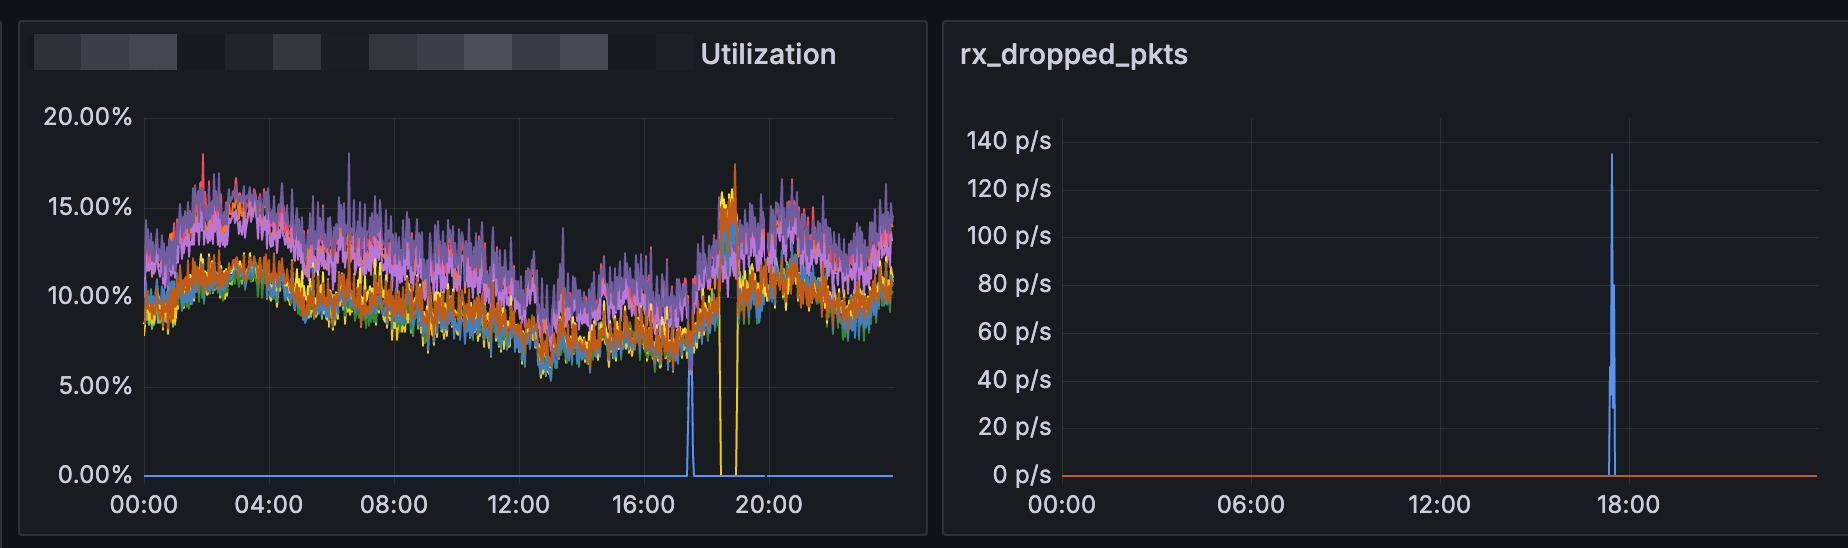
记录一下最近排查的一个问题:某台机器一上线就有丢包,同 Rack 同规格的其他机器都没有问题,由于负载都是一样的,所以问题集中到这台机器本身的问题。已经可以 100% 复现,只要一接流量,网卡就开始时不时的丢包。
网卡使用率对应丢包,左边蓝色的线是有问题的机器,0% 是下线状态,可见,只要一上线就会丢包 初步检查:网卡的 CRC 正常,光模块正常。(这些一般是丢包的常见问题)
仔细检查网卡的计数器,发现丢包发生在 rx_prio0_buf_discard: 397172。
中间经历了很多错误的排查思路,比如这个 metric 是每一个 NIC 都有一个,但是 driver 的实现应该是用了同一个 metric,因为 2 个 NIC 的数字总是相同的。
以为是 DCB 的 buffer 不够,尝试了调大 DCB 的 buffer。
$ dcb buffer show dev enp94s0f1np1
prio - buffer 0 : 0 1 : 0 2 : 0 3 : 0 4 : 0 5 : 0 6 : 0 7 : 0
buffer - size 0 : 20016b 1 : 0b 2 : 0b 3 : 0b 4 : 0b 5 : 0b 6 : 0b 7 : 0b
total - size 216288b
发现 buffer 大了丢包反而更严重了一些,buffer 调小也是有丢包。应该是和 buffer 无关。
由于是 rx 的丢包,应该是 ingress 的处理能力不足,接下来的排查包括了:
查看 PCIe 的带宽,状态;
调整 Interrupt coalescing,让它处理更快;
……都没有效果。
中间经历了一次大促,容量足够,就暂停排查了,这周又开始继续。
好像和网卡有关的东西检查都是正常的,同事建议换一张网卡试试。换之前我使出了最后的一招:server diff.
server diff 是我排查问题作为没有思路之后的一个手段,可以简化成一段 skill:
这是一个正常的机器,这是一个异常的机器。你对比一下两个机器之间的 sysctl 参数,kernel 参数,硬件规格,看下两台机器有什么不一样的部分。
AI 发现的问题如下:
能找到的差异点(按怀疑程度排)
硬件/内存健康 IPMI SEL:08/31 16:46 和 16:49 两次 Uncorrectable ECC DIMMB5;mcelog 有 08/31 15:39 一条 Memory read corrected error;随后 08/31、09/02、09/03 连续多次重启。DIMM 全是 Micron 36ASF4G72PZ-3G2J3(.144 是 Samsung M393A4K40DB3-CWE),B5 序列号 2E313345,看不出被换过。 本次启动(09-03)以来 EDAC ce/ue 都是 0,但 Dell 在 UE/CE 后可能进入 ADDDC/lockstep 降级模式, 会拉低内存带宽/延迟。 保留意见:网卡在 NUMA node0(CPU1/A 组),B5 属于 CPU2(B 组),RX ring 页也在 node0, 理论上不直接受影响;但这台机器的内存子系统整体存疑。
…
这是非常可疑的一个点,Linux 的收包链路上,NIC DMA 到内存1
PCIe NIC → PCIe Root Port/Root Complex → IOMMU → CPU Mesh/Interconnect → LLC(L3) / Memory Controller → DRAM
内存子系统异常会显著降低 host RX path 的处理和 buffer 回收能力,可能进一步造成 NIC ingress buffer 无法及时 drain,最终表现为 rx_prio0_buf_discard。
于是我下线机器之后测试内存的带宽,我们使用的服务器有 2 个 CPU,2 个 NUMA node,于是分别测试。
测试使用 stream.c 2
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
$ numactl - C 2 - m 0 . / stream
Copy : 10419.3 0.015583 0.015356 0.016709
Scale : 11657.5 0.013985 0.013725 0.014751
Add : 13445.3 0.018228 0.017850 0.018540
Triad : 13297.1 0.018250 0.018049 0.018966
$ numactl - C 2 - m 1 . / stream
Copy : 648.4 0.251102 0.246778 0.258519
Scale : 619.4 0.277245 0.258311 0.338792
Add : 668.6 0.382864 0.358960 0.420878
Triad : 665.1 0.378978 0.360838 0.429338
$ numactl - C 3 - m 0 . / stream
Copy : 13936.3 0.011795 0.011481 0.012645
Scale : 8038.1 0.020416 0.019905 0.021659
Add : 9287.6 0.028779 0.025841 0.049315
Triad : 9252.8 0.026599 0.025938 0.027369
$ numactl - C 3 - m 1 . / stream
Copy : 1626.5 0.103622 0.098372 0.116646
Scale : 652.1 0.258530 0.245347 0.309194
Add : 710.6 0.346138 0.337722 0.377382
Triad : 711.2 0.344051 0.337455 0.349108
(CPU 2 和 3 分别在 NUMA node 0 和 1)
可以看到,node 1 的内存,无论是同 NUMA node local 读写还是跨 NUMA remote 读写,速度只有区区 700MB,性能只有 node 0 的 1/17,确定 node 1 的内存有问题了。
进一步验证,由于我们使用的 NIC 是双网口 bond,port 1 的中断绑定到 node 0 的 CPU,port 2 的中断都绑定到 node 1 的 CPU,(这样提高 CPU 的利用率,又提供稳定的转发延迟)。所以可以通过关闭 port 2 来关闭 node 1 的使用,验证只有 node 1 的内存有问题。
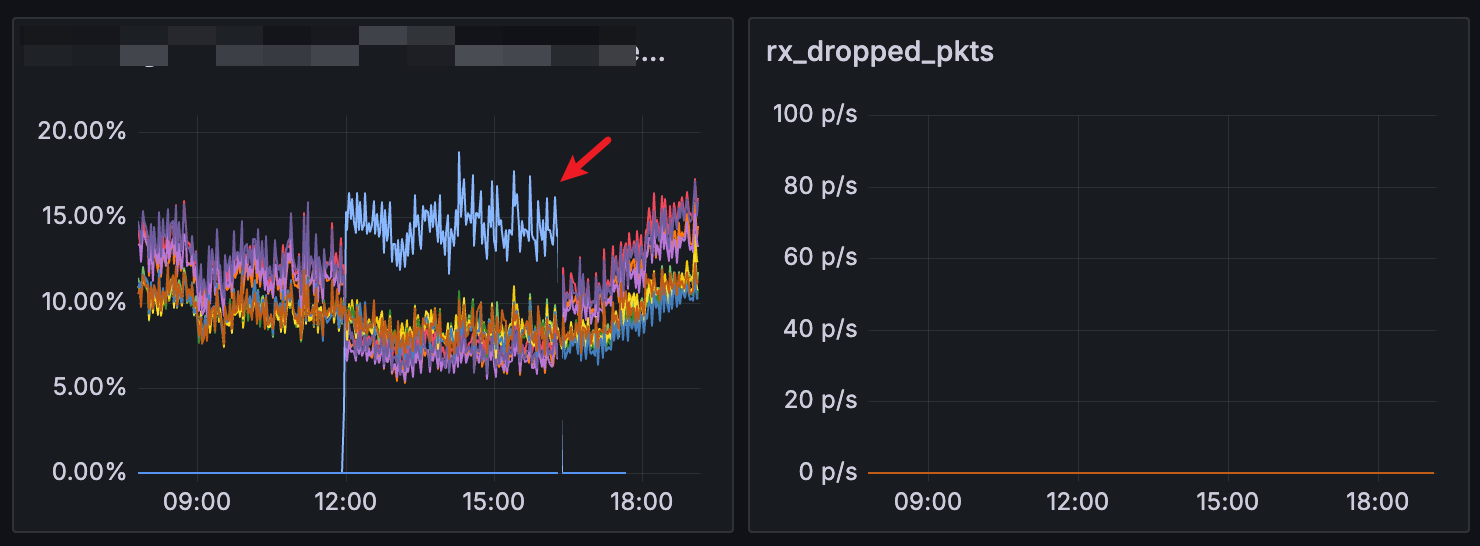
关闭一个网卡之后上线,再也没有发现有丢包。
由于是单卡模式上线,机器分到的流量不变,所以这台机器的网卡使用率是其他机器的2倍,但是丢包是0.