最近工作的项目中,用的 ORM 技术是 Hibernate,学习了一下它的用法,正好 PyCon 上我有一个演讲主题是介绍 Django 的 ORM,可以拿来比较一下。这篇文章介绍了 Hibernate 的定位,基本的概念,以及用代码演示了如何使用 Hibernate。本文的内容参考了 jboss 上的一篇教程,所有的代码直接下载:hibernate-tutorials.zip
Hibernate 是什么?
Java 是一个面向对象的编程语言,数据库提供的数据结构只有 Table。所以我们在读写数据库的数据的时候不可避免的要进行结构的转换,保存数据的时候,将 Object 变成 Table 可以保存的形式,读回数据的时候要转换回来。
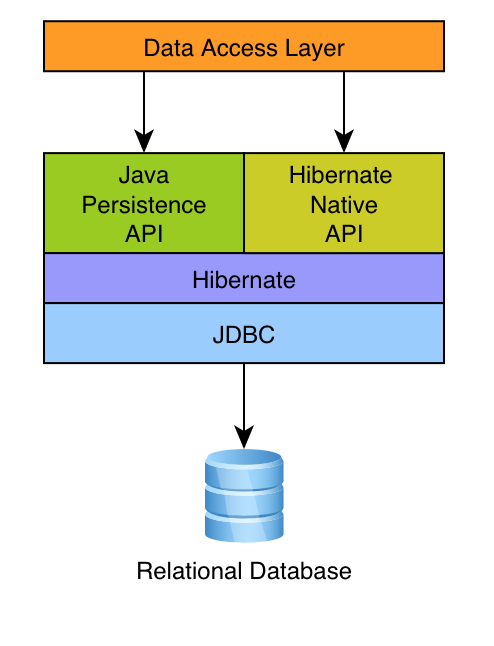
这样每次在读写数据的时候做转换,是非常重复的,开发成本很高。Hibernate 就是一个 对象/关系映射 的转换解决方案。在 Java 程序中,我们只写类,数据在保存的时候,Hibernate 负责将类的属性转换成 Table 的 Column。更确切的说,如果没有 Hibernate,我们就需要通过写 SQL 和用 JDBC 来跟数据库交互。
和其他 ORM 不同,Hibernate 没有完全屏蔽 SQL。并承诺你的关系型数据库的知识,在 Hibernate 下依然有价值(来源)。
一、使用 Hibernate 原生的 API 读取和保存数据
ORM 需要做的最终要的一件事情是负责 Class 和 Table 的数据结构的转换,在 Hibernate 中,定义这种转换有两种方式:通过配置文件,或者通过注解。
使用 Mapping 配置文件来映射Java class和Table的关系
Bundle/resources 下面的 hibernate.cfg.xml 是 Hibernate 的配置文件。有数据库地址,连接参数等配置。其中 dialect 定义了使用哪种SQL方言,在使用特定数据库的时候可以使用。
auto 可以指定启动的时候自动创建表结构:
|
1 2 |
<!-- Drop and re-create the database schema on startup --> <property name="hbm2ddl.auto">create</property> |
这个值可选的参数如下:
- create:每次加载hibernate时都会删除上一次的生成的表,然后根据你的model类再重新来生成新表,哪怕两次没有任何改变也要这样执行,这就是导致数据库表数据丢失的一个重要原因。
- create-drop :每次加载hibernate时根据model类生成表,但是sessionFactory一关闭,表就自动删除。
- update:最常用的属性,第一次加载hibernate时根据model类会自动建立起表的结构(前提是先建立好数据库),以后加载hibernate时根据 model类自动更新表结构,即使表结构改变了但表中的行仍然存在不会删除以前的行。要注意的是当部署到服务器后,表结构是不会被马上建立起来的,是要等 应用第一次运行起来后才会。
- validate :每次加载hibernate时,验证创建数据库表结构,只会和数据库中的表进行比较,不会创建新表,但是会插入新值。
<mapping /> 可以告诉 Hibernate,去哪里找描述 Class 和 Table 对应的 mapping 文件。
|
1 |
<mapping resource="org/hibernate/tutorial/hbm/Event.hbm.xml"/> |
对应路径的 mapping 文件,描述了 Java 的 Class 如何和数据库的 Table 对应:
|
1 2 3 4 5 6 7 8 9 10 11 |
<hibernate-mapping package="org.hibernate.tutorial.hbm"> <class name="Event" table="EVENTS"> <id name="id" column="EVENT_ID"> <generator class="increment"/> </id> <property name="date" type="timestamp" column="EVENT_DATE"/> <property name="title"/> </class> </hibernate-mapping> |
Hibernate 会使用 java.lang.ClassLoader 去加载这些类。
有关 Entity 有两点需要注意:
- 这个类用标准的 JavaBean 命令方式设置 getter 和 setter 方法,private 属性也有。这是推荐做法但不是必须做法;
- 无参数构造函数是必须有的,Hibernate 需要用Java的反射通过这个构造函数构造对象。
Mapping 文件的详细解释
父节点的属性中,name 结合 package 定义个 FQN,对应 java 的 class;table 定义了数据库的表名字;
子节点中:
- 需要定义
<id/>Element 来告诉 Hibernate 如何找到表中的唯一的一个 row;推荐使用 Primary key <property/>定义了属性和表字段的 mapping,column定义了表 Column 的名字,如果不写的话 Hibernate 默认会使用 property 的 name;type是数据类型。这个数据类型既不是 SQL 的类型,也不是 Java 的类型,而是 Hibernate 的类型,负责在 Java 和 SQL 之间做转换。如果这个 type 没写的话,Hibernate 会尝试通过 Java 的反射,按照 Java 的类型找到对应的 mapping 类型;
测试代码
示例代码如下(不要复制粘贴,如果需要运行请直接复制本文开头提供的附件):
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 |
package org.hibernate.tutorial.hbm; import java.util.Date; import java.util.List; import org.hibernate.Session; import org.hibernate.SessionFactory; import org.hibernate.boot.MetadataSources; import org.hibernate.boot.registry.StandardServiceRegistry; import org.hibernate.boot.registry.StandardServiceRegistryBuilder; import junit.framework.TestCase; /** * Illustrates use of Hibernate native APIs. * * @author Steve Ebersole */ public class NativeApiIllustrationTest extends TestCase { private SessionFactory sessionFactory; @Override protected void setUp() throws Exception { // A SessionFactory is set up once for an application! final StandardServiceRegistry registry = new StandardServiceRegistryBuilder() .configure() // configures settings from hibernate.cfg.xml .build(); try { sessionFactory = new MetadataSources( registry ).buildMetadata().buildSessionFactory(); } catch (Exception e) { // The registry would be destroyed by the SessionFactory, but we had trouble building the SessionFactory // so destroy it manually. StandardServiceRegistryBuilder.destroy( registry ); } } @Override protected void tearDown() throws Exception { if ( sessionFactory != null ) { sessionFactory.close(); } } @SuppressWarnings("unchecked") public void testBasicUsage() { // create a couple of events... Session session = sessionFactory.openSession(); session.beginTransaction(); session.save( new Event( "Our very first event!", new Date() ) ); session.save( new Event( "A follow up event", new Date() ) ); session.getTransaction().commit(); session.close(); // now lets pull events from the database and list them session = sessionFactory.openSession(); session.beginTransaction(); List result = session.createQuery( "from Event" ).list(); for ( Event event : (List<Event>) result ) { System.out.println( "Event (" + event.getDate() + ") : " + event.getTitle() ); } session.getTransaction().commit(); session.close(); } } |
下面来分析代码。
在 setUp 中,首先构建了一个 org.hibernate.boot.registry.StandardServiceRegistry ,用来处理 hibernate.cfg.xml 等配置信息(sessionFactory 会使用 serviceRegistry 中的配置信息)。
|
1 |
sessionFactory = new MetadataSources( registry ).buildMetadata().buildSessionFactory(); |
在 setUp 中,首先构建了一个 org.hibernate.boot.registry.StandardServiceRegistry ,用来处理 hibernate.cfg.xml 等配置信息(sessionFactory 会使用 serviceRegistry 中的配置信息)。
我们使用 org.hibernate.boot.MetadataSource 先创建了 org.hibernate.boot.MetadataSources ,这个类表示了 domain Model。然后基于此创建了 SessionFactory。
最后一步就是创建 SessionFactory 了,这是一个全局单例的类,线程安全。
SessionFactory 是 Session 的工厂类,每次使用一个 Session 来完成一块任务:
|
1 2 3 4 5 6 |
Session session = sessionFactory.openSession(); session.beginTransaction(); session.save( new Event( "Our very first event!", new Date() ) ); session.save( new Event( "A follow up event", new Date() ) ); session.getTransaction().commit(); session.close(); |
以上代码中,testBasicUseage() 先创建了一个 Event 对象,然后交给 Hibernate 处理,Hibernate 的 save() 方法将其插入数据库中。
获取对象的代码如下:
|
1 2 3 4 5 6 7 8 |
session = sessionFactory.openSession(); session.beginTransaction(); List result = session.createQuery( "from Event" ).list(); for ( Event event : (List<Event>) result ) { System.out.println( "Event (" + event.getDate() + ") : " + event.getTitle() ); } session.getTransaction().commit(); session.close(); |
我们通过写 Hibernate Query Language 向 Hibernate 表达查询,Hibernate 将其转换成 SQL 执行查询,然后将结果转换成我们需要的 class。
使用注解描述 Java class 和 Table 的映射关系
使用注解API,在配置文件中我们的 mapping 字段需要设置为:
|
1 2 |
<!-- Names the annotated entity class --> <mapping class="org.hibernate.tutorial.annotations.Event"/> |
其他的配置项和前面一样。然后,我们在定义 class 和 table 的映射的时候,不再使用 xml 文件了,而是直接在 class 上面注释:
|
1 2 3 4 5 |
@Entity @Table( name = "EVENTS" ) public class Event { ... } |
@Entity 的注解和 xml 中的 <class /> 作用一样。这里显示地指定了表的名字,如果不指定的话,就会默认使用类名 EVENT。
字段的定义如下:
|
1 2 3 4 5 6 |
@Id @GeneratedValue(generator="increment") @GenericGenerator(name="increment", strategy = "increment") public Long getId() { return id; } |
@javax.persistence.Id 定义了实体的 ID;
@javax.persistence.GeneratedValue 和 @org.hibernate.annotations.GenericGenerator 指示 Hibernate 应该用 increment 生成器自动生成这个字段。
|
1 2 3 4 5 6 7 8 9 |
public String getTitle() { return title; } @Temporal(TemporalType.TIMESTAMP) @Column(name = "EVENT_DATE") public Date getDate() { return date; } |
同 xml 配置方式一样,date 也需要特殊处理一下。
实体的属性默认将会持久化,所以这个类中我们没有写 title 的 annotation,但是 title 也会被持久化。
示例代码:这部分的例子和上面一样。
二、使用 Java Persistence API(JPA)
上面我们使用的配置文件是 hibernate.cfg.xml,而 JPA 定义了自己的配置方式,叫做 persistence.xml 。启动方式是 JPA 定义的规范,Hibernate 作为持久化的提供者,需要读取并应用 META-INF/persistence.xml 里面的设置。
persistence.xml 文件范例如下:
|
1 2 3 4 5 6 7 8 |
<persistence xmlns="http://java.sun.com/xml/ns/persistence" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://java.sun.com/xml/ns/persistence http://java.sun.com/xml/ns/persistence/persistence_2_0.xsd" version="2.0"> <persistence-unit name="org.hibernate.tutorial.jpa"> ... </persistence-unit> </persistence> |
对于每一个 persistence-unit 需要提供一个 unique name。应用在获得 javax.persistence.EntityManagerFactory 引用的时候,使用这个 unique name 来获得配置的引用。
之前的配置文件中的配置项,先在要使用 javax.persistence 前缀来区分开。对于 Herbenate 特殊肚饿配置项要用 hibernate. 前缀。
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
<persistence-unit name="org.hibernate.tutorial.jpa"> <description> Persistence unit for the JPA tutorial of the Hibernate Getting Started Guide </description> <class>org.hibernate.tutorial.em.Event</class> <properties> <property name="javax.persistence.jdbc.driver" value="org.h2.Driver" /> <property name="javax.persistence.jdbc.url" value="jdbc:h2:mem:db1;DB_CLOSE_DELAY=-1;MVCC=TRUE" /> <property name="javax.persistence.jdbc.user" value="sa" /> <property name="javax.persistence.jdbc.password" value="" /> <property name="hibernate.show_sql" value="true" /> <property name="hibernate.hbm2ddl.auto" value="create" /> </properties> </persistence-unit> |
除此之外,<class /> 的内容和我们在前面看到的 Hibernate 配置文件一样。
示例代码
前面的例子中使用的是 Hibernate 的 native API,这里我们使用 JPA 的 API 。
获取 SessionFactory:
|
1 2 3 |
protected void setUp() throws Exception { sessionFactory = Persistence.createEntityManagerFactory( "org.hibernate.tutorial.jpa" ); } |
注意这里使用的 persistence unit name 是 org.hibernate.tutorial.jpa ,和上面提到的配置问题件对应。
使用 javax.persistence.EntityManager 保存实体。Hibernate 中 save 的步骤,在 JPA 中叫做 persist.
|
1 2 3 4 5 6 |
EntityManager entityManager = sessionFactory.createEntityManager(); entityManager.getTransaction().begin(); entityManager.persist( new Event( "Our very first event!", new Date() ) ); entityManager.persist( new Event( "A follow up event", new Date() ) ); entityManager.getTransaction().commit(); entityManager.close(); |
三、Envers 功能
Hibernate 有一个功能,叫做 Envers,就是可以将数据的历史版本都保存下来。数据及时更改了,也可以找到曾经的状态。
这个功能也不是无成本的,需要一些保存历史版本,保存和读取的时候,也需要额外的计算,所以我们只在需要的时候这么做。
我们通过@org.hibernate.envers.Audited 这个注解告诉Hibernate需要保留这个类的历史版本,然后,我们可以 org.hibernate.envers.AuditReader 来读取数据的历史版本。
示例代码
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 |
public void testBasicUsage() { // create a couple of events EntityManager entityManager = entityManagerFactory.createEntityManager(); entityManager.getTransaction().begin(); entityManager.persist( new Event( "Our very first event!", new Date() ) ); entityManager.persist( new Event( "A follow up event", new Date() ) ); entityManager.getTransaction().commit(); entityManager.close(); // now lets pull events from the database and list them entityManager = entityManagerFactory.createEntityManager(); entityManager.getTransaction().begin(); List<Event> result = entityManager.createQuery( "from Event", Event.class ).getResultList(); for ( Event event : result ) { System.out.println( "Event (" + event.getDate() + ") : " + event.getTitle() ); } entityManager.getTransaction().commit(); entityManager.close(); // so far the code is the same as we have seen in previous tutorials. Now lets leverage Envers... // first lets create some revisions entityManager = entityManagerFactory.createEntityManager(); entityManager.getTransaction().begin(); Event myEvent = entityManager.find( Event.class, 2L ); // we are using the increment generator, so we know 2 is a valid id myEvent.setDate( new Date() ); myEvent.setTitle( myEvent.getTitle() + " (rescheduled)" ); entityManager.getTransaction().commit(); entityManager.close(); // and then use an AuditReader to look back through history entityManager = entityManagerFactory.createEntityManager(); entityManager.getTransaction().begin(); myEvent = entityManager.find( Event.class, 2L ); assertEquals( "A follow up event (rescheduled)", myEvent.getTitle() ); AuditReader reader = AuditReaderFactory.get( entityManager ); Event firstRevision = reader.find( Event.class, 2L, 1 ); assertFalse( firstRevision.getTitle().equals( myEvent.getTitle() ) ); assertFalse( firstRevision.getDate().equals( myEvent.getDate() ) ); Event secondRevision = reader.find( Event.class, 2L, 2 ); assertTrue( secondRevision.getTitle().equals( myEvent.getTitle() ) ); assertTrue( secondRevision.getDate().equals( myEvent.getDate() ) ); entityManager.getTransaction().commit(); entityManager.close(); } |
参考资料:
- https://www.jianshu.com/p/64fef4fa5645
- https://www.yiibai.com/spring/maven-spring-hibernate-annotation-mysql-example.html
- http://hibernate.org/
- https://docs.jboss.org/hibernate/orm/5.4/userguide/html_single/Hibernate_User_Guide.html
- https://docs.jboss.org/hibernate/orm/3.5/reference/zh-CN/html/tutorial.html
- https://docs.jboss.org/hibernate/orm/5.4/quickstart/html_single/